Teorema Central do Limite
O Teorema Central do Limite (TCL) é um dos resultados mais importantes de toda a estatística. Ele explica por que tantos procedimentos estatísticos, testes t, intervalos de confiança, ANOVA, podem se apoiar em uma aproximação normal mesmo quando os dados originais não são normais, desde que você esteja observando uma soma ou uma média de muitas observações, e não as observações individuais em si.
O que o teorema realmente diz
Sejam \(X_1, X_2, \ldots, X_n\) variáveis aleatórias independentes e identicamente distribuídas, provenientes de qualquer população com média finita \(\mu\) e variância finita \(\sigma^2\). A própria população pode ter qualquer forma: assimétrica, bimodal, uniforme, o que for, desde que tenha média e variância finitas. Define-se a média amostral como:
\[\bar{X}_n = \frac{1}{n}\sum_{i=1}^n X_i\]
Quando \(n \to \infty\):
\[\bar{X}_n \ \xrightarrow{d}\ N\!\left(\mu, \ \frac{\sigma^2}{n}\right)\]
de forma equivalente:
\[\frac{\bar{X}_n - \mu}{\sigma/\sqrt{n}} \ \xrightarrow{d}\ N(0,1)\]
Três afirmações distintas estão reunidas neste único teorema, e as três importam:
- Forma: a distribuição amostral de \(\bar{X}_n\) se torna aproximadamente normal, independentemente da forma original da população.
- Centro: ela fica centrada exatamente na média populacional \(\mu\) (sem viés).
- Dispersão: sua dispersão diminui a uma taxa precisa e conhecida, o erro padrão \(\sigma/\sqrt{n}\), de modo que a precisão melhora proporcionalmente a \(\sqrt{n}\), não a \(n\) (quadruplicar o tamanho da amostra só reduz o erro padrão à metade).
Uma demonstração concreta: amostrando de uma população assimétrica
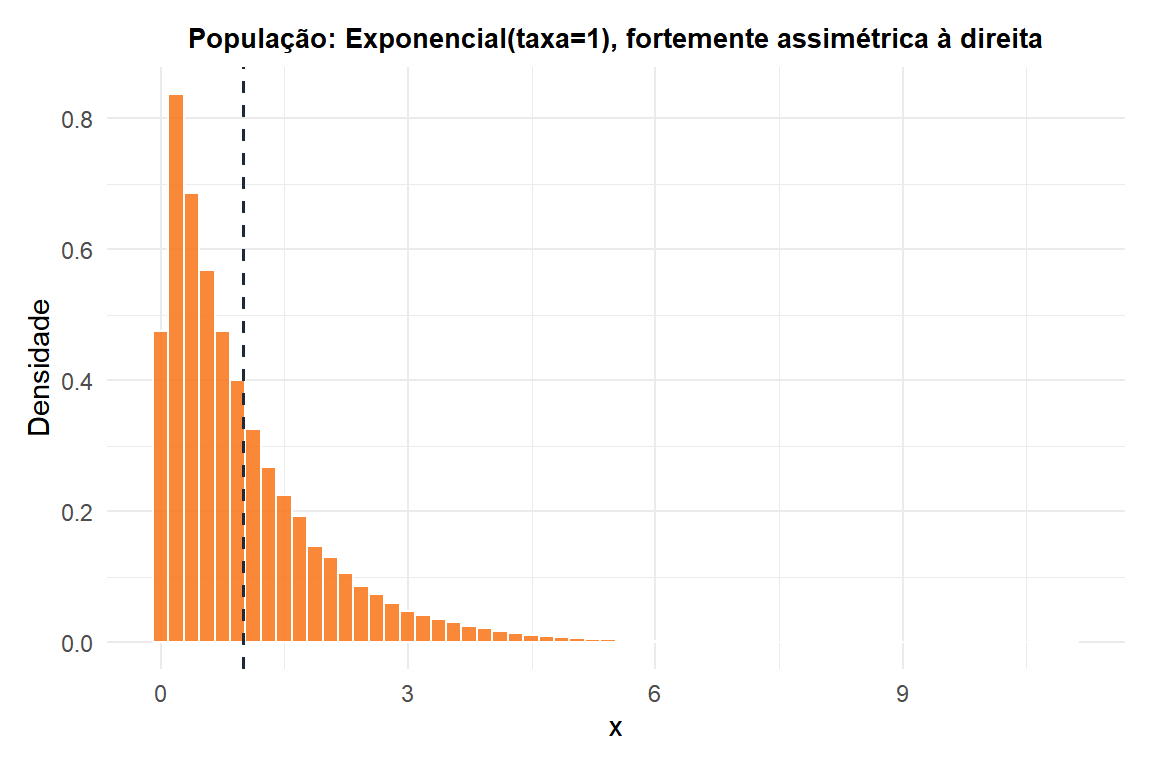
Para deixar a conclusão do teorema bem evidente, começamos com uma população deliberadamente no “pior caso”: a distribuição Exponencial com taxa \(1\). Ela tem média \(\mu = 1\), desvio padrão \(\sigma = 1\), e é fortemente assimétrica à direita, nada parecida com uma curva em forma de sino.
Agora extraímos repetidamente amostras de tamanho \(n\) dessa população, calculamos a média de cada amostra, e observamos a distribuição dessas médias, a distribuição amostral de \(\bar{X}_n\).
Foram simuladas 20.000 médias amostrais replicadas para cada tamanho de amostra \(n\) a partir de uma Exponencial(taxa=1), com set.seed(123):
set.seed(123)
results <- sapply(c(2, 5, 30, 100), function(n) {
  means <- replicate(20000, mean(rexp(n, rate = 1)))
  c(mean = mean(means), sd = sd(means))
})| Tamanho da amostra \(n\) | Média de \(\bar{X}_n\) em 20.000 amostras simuladas | DP de \(\bar{X}_n\) (simulado) | EP teórico \(=\sigma/\sqrt{n}\) |
|---|---|---|---|
| 2 | 1,002 | 0,702 | 0,707 |
| 5 | 0,993 | 0,445 | 0,447 |
| 30 | 1,001 | 0,182 | 0,183 |
| 100 | 1,000 | 0,0989 | 0,100 |
Duas coisas para notar. A média simulada de \(\bar{X}_n\) permanece essencialmente em \(\mu=1\) para todo \(n\) (afirmação 2, sem viés, mesmo com \(n=2\)), enquanto o DP simulado de \(\bar{X}_n\) diminui e corresponde quase exatamente à fórmula teórica \(\sigma/\sqrt{n}\) em cada um dos tamanhos (afirmação 3). O que muda com \(n\) é apenas a forma da distribuição (afirmação 1): com \(n=2\), a distribuição amostral de \(\bar{X}_2\) ainda é visivelmente assimétrica à direita, herdando a assimetria da população; com \(n=30\) já se parece bastante com uma curva simétrica em forma de sino; com \(n=100\) é praticamente indistinguível de uma normal.

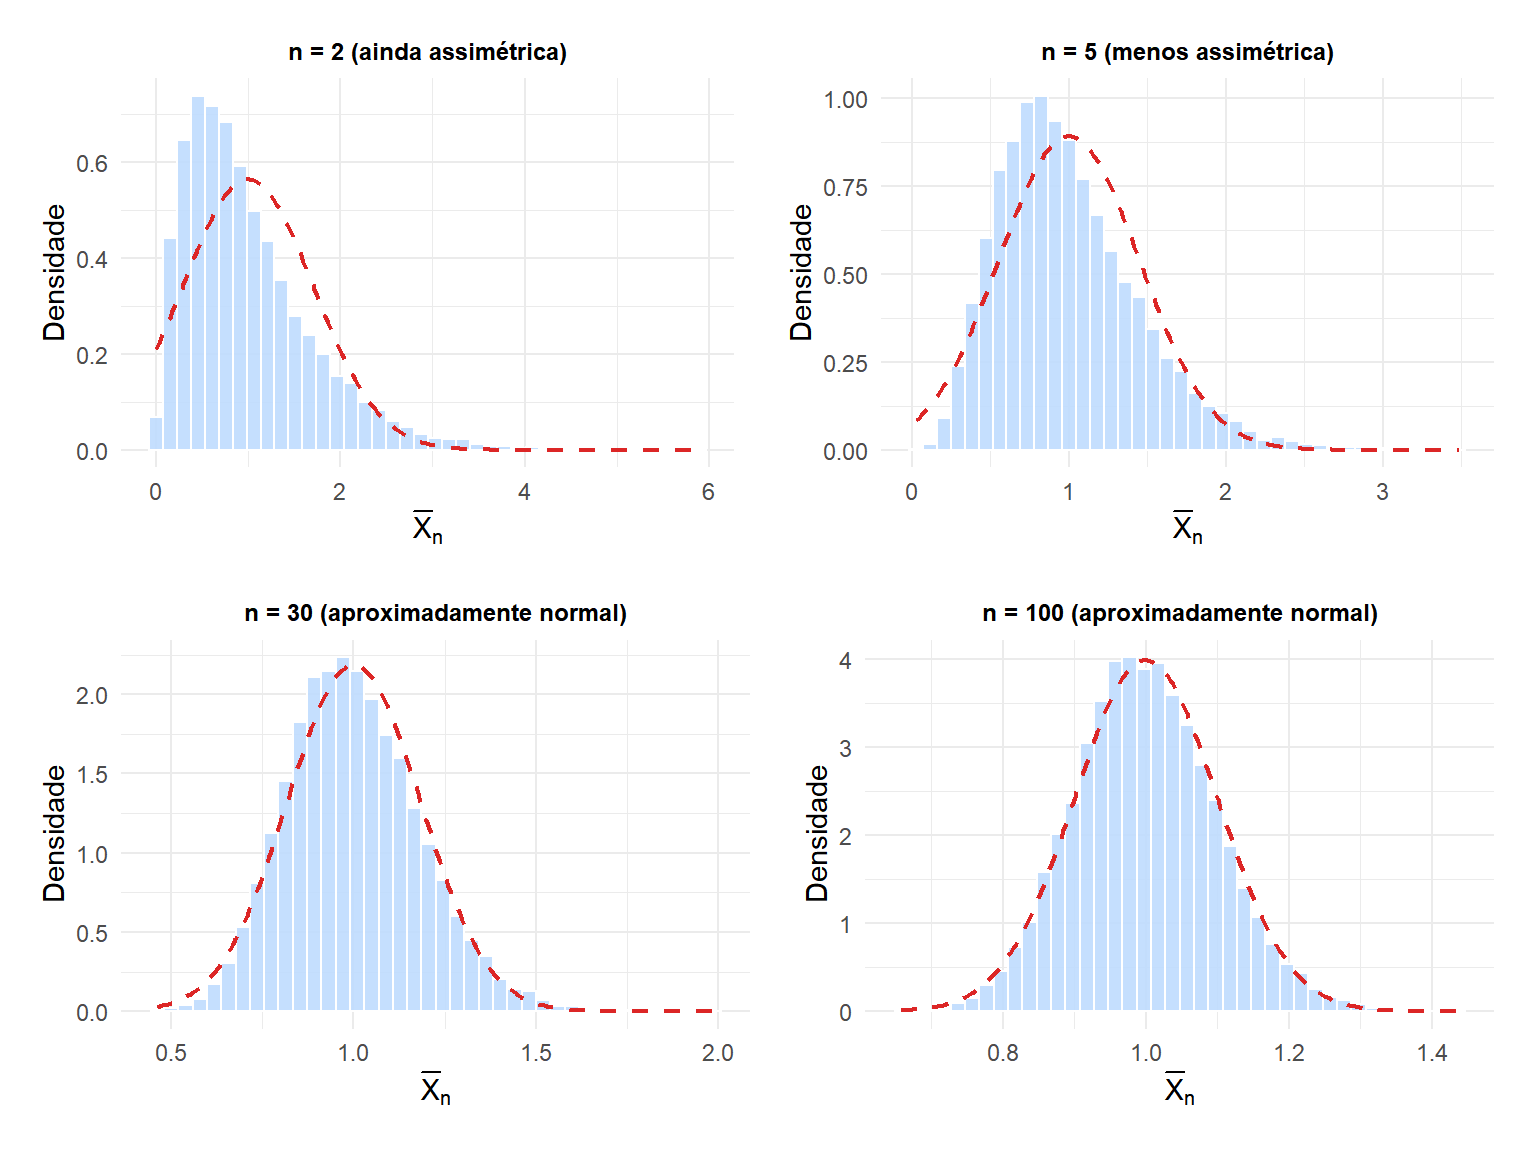
Os histogramas azuis são as distribuições amostrais simuladas de \(\bar{X}_n\); a linha vermelha tracejada é a curva normal teórica \(N(\mu, \sigma^2/n)\) prevista pelo TCL. Com \(n=2\) o histograma ainda se inclina visivelmente para a direita, afastado da curva normal. Com \(n=30\) e \(n=100\), o histograma e a curva normal teórica ficam quase sobrepostos, mesmo que a população de onde vieram nunca tenha sido nem de longe normal.
Por que isso importa na prática
O TCL é a justificativa teórica por trás de uma enorme parte da estatística aplicada neste site:
- O teste z e o teste t para uma média de uma única amostra dependem da distribuição amostral de \(\bar{X}_n\) ser aproximadamente normal.
- Os intervalos de confiança para uma média são construídos diretamente a partir da aproximação normal (ou t) à distribuição amostral de \(\bar{X}_n\).
- A robustez da ANOVA a pequenos desvios de normalidade vem da mesma fonte: a estatística do teste é construída a partir de médias de grupo, e o TCL empurra essas médias em direção à normalidade mesmo quando os dados brutos não são normais.
Nenhum desses métodos exige que os dados originais sejam normais, apenas que a estatística relevante (tipicamente uma média ou uma soma) seja ela mesma aproximadamente normal, o que o TCL garante para um \(n\) suficientemente grande.
⚠️ O quão grande n precisa ser depende de quão assimétrica é a população
Não existe um corte universal como \(n \geq 30\) que funcione para qualquer população (esse número é uma regra prática popular, não uma garantia matemática). Uma população apenas levemente assimétrica pode precisar de só \(n=10\) ou \(15\) para que a distribuição amostral da média pareça convincentemente normal. Uma população com assimetria extrema ou caudas muito pesadas (como o exemplo exponencial acima, ou pior, uma distribuição de Pareto ou lei de potência) pode precisar de \(n\) na ordem das centenas. Pior ainda, se a população nem tiver variância finita (algumas distribuições de caudas muito pesadas), o TCL simplesmente não se aplica: nenhum tamanho de amostra vai resolver isso.
Sempre verifique: a grandeza que você está calculando a média tem uma população razoavelmente bem comportada, com variância finita? Em caso de dúvida séria, use um método não paramétrico ou uma abordagem bootstrap em vez de confiar no TCL.
Executando a simulação em R
Isso reproduz toda a demonstração do zero: amostrar de uma população fortemente assimétrica e observar a distribuição amostral da média se estreitar e se normalizar conforme \(n\) cresce.
set.seed(123)

# População: Exponencial(taxa = 1), média = 1, dp = 1, fortemente assimétrica
hist(rexp(100000, rate = 1), breaks = 60, main = "Forma da população")

# Distribuições amostrais da média para n crescentes
for (n in c(2, 5, 30, 100)) {
  means <- replicate(20000, mean(rexp(n, rate = 1)))
  cat("n =", n,
      " média =", round(mean(means), 3),
      " dp =",    round(sd(means), 3),
      " EP teórico =", round(1/sqrt(n), 3), "\n")
}
💡 O TCL é sobre a distribuição amostral, não sobre o seu único conjunto de dados
Uma confusão muito comum: o TCL não diz que os seus dados brutos vão parecer normais se você simplesmente coletar o suficiente deles. Os seus dados brutos mantêm qualquer forma que a população tenha, não importa quão grande seja a sua única amostra. O que se torna normal é a distribuição de uma estatística-resumo (tipicamente a média) calculada em muitas amostras repetidas, ou, de forma equivalente, a distribuição amostral teórica da qual uma única média amostral é extraída. Se você plotar um histograma das suas observações brutas e ele ainda parecer assimétrico mesmo com uma amostra enorme, isso é completamente esperado e não contradiz o TCL de forma alguma.
Para a pergunta relacionada, mas distinta, de onde \(\bar{X}_n\) termina (em vez de como ele flutua em torno desse ponto), veja a Lei dos Grandes Números.

