Variáveis aleatórias bidimensionais
Até agora, as variáveis aleatórias unidimensionais descreviam uma variável por vez. Quando duas variáveis aleatórias são medidas no mesmo indivíduo ou experimento, você precisa de ferramentas que descrevam o comportamento conjunto delas, não apenas cada uma separadamente. As variáveis aleatórias bidimensionais fornecem exatamente isso: um arcabouço para estudar como duas variáveis se relacionam, dependem ou se influenciam mutuamente.
Definição
Uma variável aleatória bidimensional é um par \((X, Y)\) de variáveis aleatórias definidas no mesmo espaço de probabilidade:
\[ (X, Y): \Omega \rightarrow \mathbb{R}^2 \]
Cada resultado \(\omega \in \Omega\) recebe um par de números reais \((X(\omega), Y(\omega))\). O comportamento probabilístico completo do par é descrito pela sua distribuição conjunta.
Distribuição conjunta
A distribuição conjunta descreve a probabilidade de \((X, Y)\) assumir valores específicos simultaneamente.
Para variáveis discretas, a função de massa de probabilidade conjunta é:
\[p_{X,Y}(x, y) = P(X = x,\ Y = y)\]
Para variáveis contínuas, a função de densidade de probabilidade conjunta \(f_{X,Y}(x, y)\) satisfaz:
\[P((X,Y) \in A) = \iint_A f_{X,Y}(x, y)\, dx\, dy\]
Em ambos os casos, a distribuição conjunta deve satisfazer a não negatividade e a normalização (a probabilidade total soma ou integra 1).
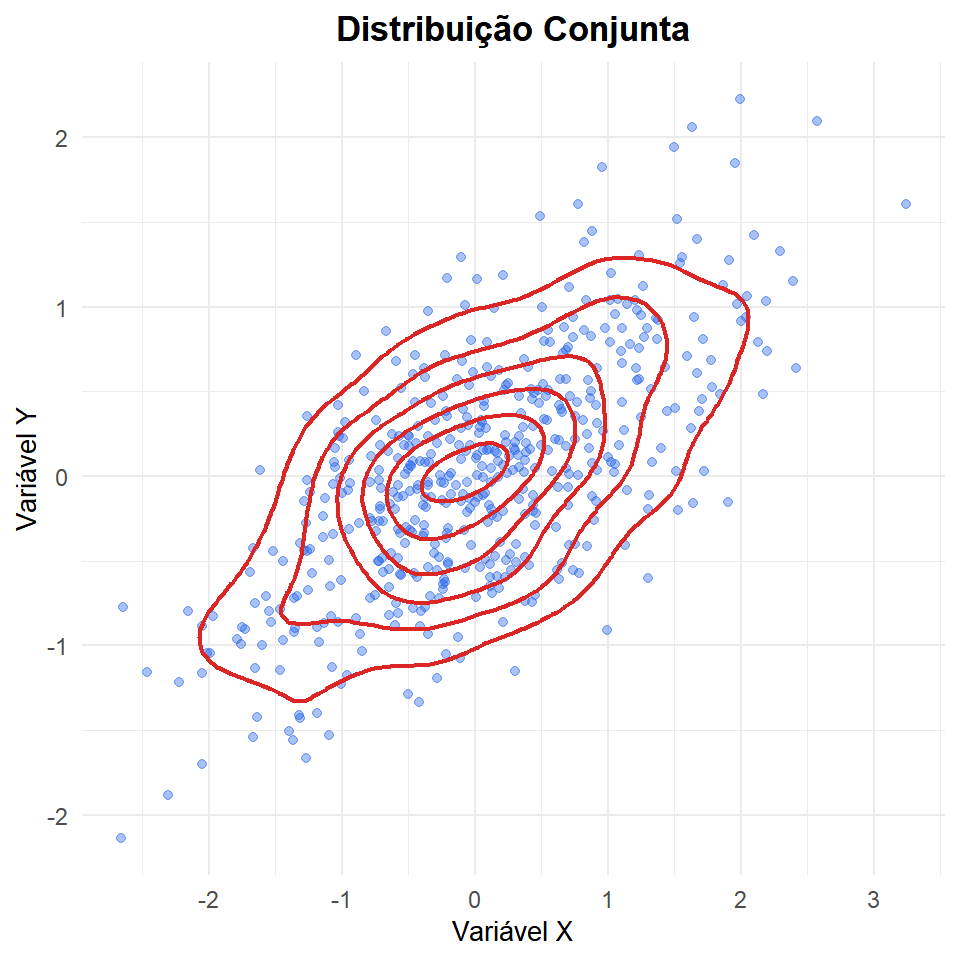
Figure 1: Distribuição conjunta de duas variáveis contínuas correlacionadas: cada ponto é uma observação, os contornos mostram regiões de densidade igual
Uma pesquisa registra o número de horas de exercício por semana (\(X\)) e a pontuação de saúde autodeclarada (\(Y\), de 1 a 3) para uma amostra de indivíduos. A PMF conjunta é:
| \(Y=1\) (ruim) | \(Y=2\) (regular) | \(Y=3\) (boa) | \(p_X(x)\) | |
|---|---|---|---|---|
| \(X=0\) (sedentário) | 0,15 | 0,10 | 0,05 | 0,30 |
| \(X=1\) (moderado) | 0,05 | 0,20 | 0,15 | 0,40 |
| \(X=2\) (ativo) | 0,02 | 0,08 | 0,20 | 0,30 |
| \(p_Y(y)\) | 0,22 | 0,38 | 0,40 | 1,00 |
As somas por linha dão a distribuição marginal de \(X\); as somas por coluna dão a distribuição marginal de \(Y\).

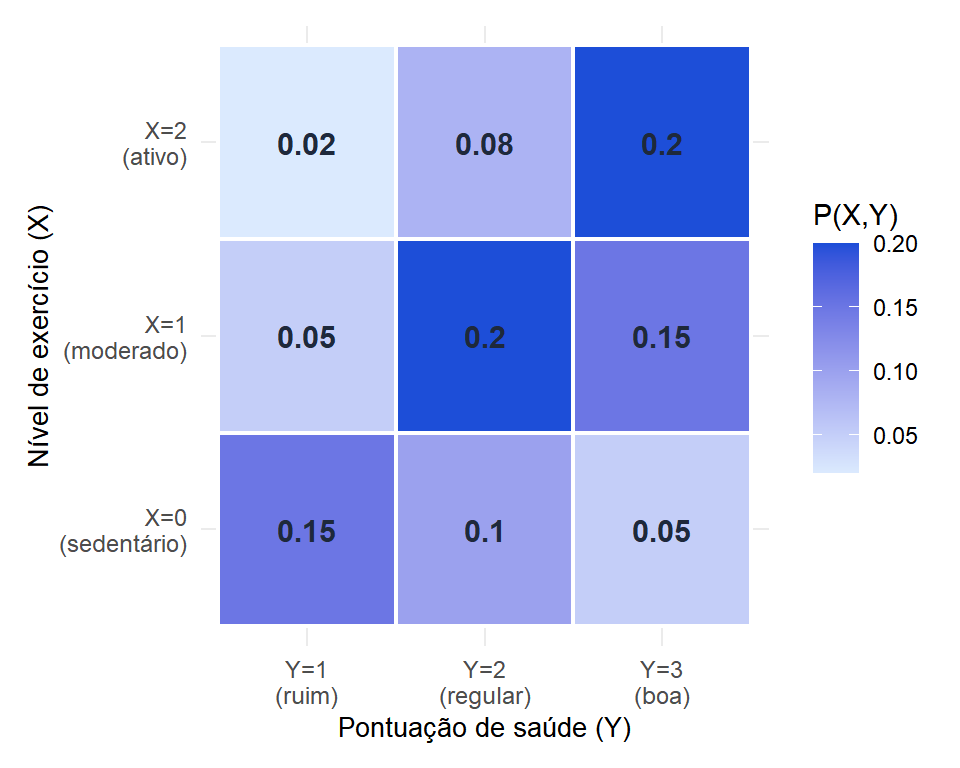
Figure 2: PMF conjunta como mapa de calor: células mais escuras têm maior probabilidade conjunta
Distribuições marginais
A distribuição marginal de \(X\) é obtida somando (ou integrando) a distribuição conjunta sobre todos os valores de \(Y\), e vice-versa.
Para variáveis discretas:
\[p_X(x) = \sum_{y} p_{X,Y}(x, y) \qquad p_Y(y) = \sum_{x} p_{X,Y}(x, y)\]
Para variáveis contínuas:
\[f_X(x) = \int_{-\infty}^{\infty} f_{X,Y}(x, y)\, dy \qquad f_Y(y) = \int_{-\infty}^{\infty} f_{X,Y}(x, y)\, dx\]
Usando a tabela acima, a distribuição marginal de \(X\) é:
- \(P(X=0) = 0{,}15 + 0{,}10 + 0{,}05 = 0{,}30\)
- \(P(X=1) = 0{,}05 + 0{,}20 + 0{,}15 = 0{,}40\)
- \(P(X=2) = 0{,}02 + 0{,}08 + 0{,}20 = 0{,}30\)
Esses são os totais das linhas. A marginal de \(Y\) é calculada da mesma forma a partir dos totais das colunas.
Distribuições condicionais
A distribuição condicional de \(X\) dado \(Y = y\) descreve como \(X\) se comporta quando fixamos o valor de \(Y\). Para variáveis discretas:
\[P(X = x \mid Y = y) = \frac{P(X = x,\ Y = y)}{P(Y = y)}\]
Para variáveis contínuas:
\[f_{X \mid Y}(x \mid y) = \frac{f_{X,Y}(x, y)}{f_Y(y)}\]
Usando a tabela acima, qual é a distribuição do nível de exercício dado que uma pessoa tem saúde ruim ((Y = 1))?
\[P(X=0 \mid Y=1) = \frac{0{,}15}{0{,}22} \approx 0{,}682\] \[P(X=1 \mid Y=1) = \frac{0{,}05}{0{,}22} \approx 0{,}227\] \[P(X=2 \mid Y=1) = \frac{0{,}02}{0{,}22} \approx 0{,}091\]
Entre as pessoas com saúde ruim, 68% são sedentárias e apenas 9% são ativas. Essa é a distribuição condicional de \(X\) dado \(Y = 1\).
Independência
\(X\) e \(Y\) são independentes se e somente se sua distribuição conjunta se fatora no produto das distribuições marginais:
\[p_{X,Y}(x, y) = p_X(x) \cdot p_Y(y) \quad \text{(discretas)}\]
\[f_{X,Y}(x, y) = f_X(x) \cdot f_Y(y) \quad \text{(contínuas)}\]
Na prática, para verificar a independência em uma tabela discreta: confirme que cada célula é igual ao produto de suas marginais de linha e coluna. Uma única célula que viole isso já é suficiente para concluir dependência.
Para a tabela exercício/saúde, verificando a célula \((X=0, Y=3)\):
\[p_X(0) \cdot p_Y(3) = 0{,}30 \times 0{,}40 = 0{,}12 \neq 0{,}05 = p_{X,Y}(0,3)\]
As variáveis não são independentes: o nível de exercício e a pontuação de saúde estão associados.
⚠️ Correlação zero não significa independência
Duas variáveis podem ter covariância zero (e, portanto, correlação zero) e ainda serem dependentes. A covariância só capta a dependência linear. Se \(Y = X^2\) e \(X\) é simétrica em torno de zero, então \(\text{Cov}(X, Y) = 0\), mas \(Y\) é completamente determinada por \(X\). Independência implica correlação zero, mas correlação zero não implica independência.
💡 Como verificar a independência na prática
Para uma tabela conjunta discreta: verifique se cada probabilidade de célula é igual a (marginal de linha) × (marginal de coluna). Se mesmo uma célula falhar, as variáveis são dependentes. Para distribuições conjuntas contínuas: verifique se \(f_{X,Y}(x,y)\) pode ser escrita como o produto de uma função apenas de \(x\) e uma função apenas de \(y\).

